使用 Systemd 定時器可靠地執行 ownCloud 後台作業
將按需作業運行替換為 systemd 定時器,該定時器每 15 分鐘執行一次 ownCloud 支援的 occ system:cron 命令。
如果某個指令導致您的 Ubuntu 桌面運作緩慢或伺服器記憶體不足,請將該指令及其子程序放入由 systemd 管理的 cgroup 中,並設定 CPU 配額和記憶體上限。在目前的 Ubuntu 版本中,systemd-run --scope這是最方便的方案:它會在臨時作用域中啟動該命令,然後 systemd 透過 cgroup 控制來套用這些限制。
以下範例將工作負載限制為單一 CPU 效能的一半和 1 GiB 記憶體。這些限制適用於整個範圍,包括子進程;它們並不保證程式將以特定速度運行。
繁忙的進程可能會與互動式應用程式爭用資源,而佔用大量記憶體的進程則可能導致機器進入記憶體回收或記憶體不足狀態。 cgroup 將進程及其子進程分組,以便核心可以管理並約束該群組進程。 Ubuntu 的 systemd 提供了一個方便的介面來控制這些進程。
CPU 和記憶體設定的行為有所不同。 `cgroup.memory`CPUQuota=50%將 CPU 時間限制為單一 CPU 容量的一半,並按調度週期進行平均。 `cgroup.memory` 的值200%表示最多可以使用兩個 CPU 的可用時間。這是一個上限,而不是 CPU 優先權或預留。 `cgroup.memory`MemoryMax=1G為分配給 cgroup 的記憶體設定硬性上限;如果工作負載無法保持在該上限以下,核心可能會回收記憶體或對該 cgroup 中的進程執行記憶體不足終止操作。選擇一個足以滿足應用程式及其子進程需求的上限值。
使用 systemd 的 Ubuntu 系統通常採用統一的 cgroup v2 層級結構。在依賴後續顯示的路徑之前,請確認目前配置是否正確:
stat -fc %T /sys/fs/cgroup
systemctl --version | head -n 1第一個命令應該會報告cgroup2fs檔案系統類型。如果它報告的是其他檔案系統類型,則本文中提供的 cgroup v2 檔案路徑將不再適用。 systemd 屬性可能仍然受支持,但請使用相應的發行版文檔,而不是直接複製 v2 路徑。
如果某個屬性被拒絕,也要檢查 systemd 的確切版本。 Ubuntu 的 Noble 文件將CPUQuota=其描述MemoryMax=為資源控制設定;較舊的 Ubuntu 版本可能打包了不同版本的 systemd。
透過運行程序systemd-run,替換為實際的可執行檔及其參數。對於目前目錄中的命令,請使用./並傳遞所有參數--:
systemd-run --scope \
  -p CPUQuota=50% \
  -p MemoryMax=1G \
  -- ./my-program --input data.csv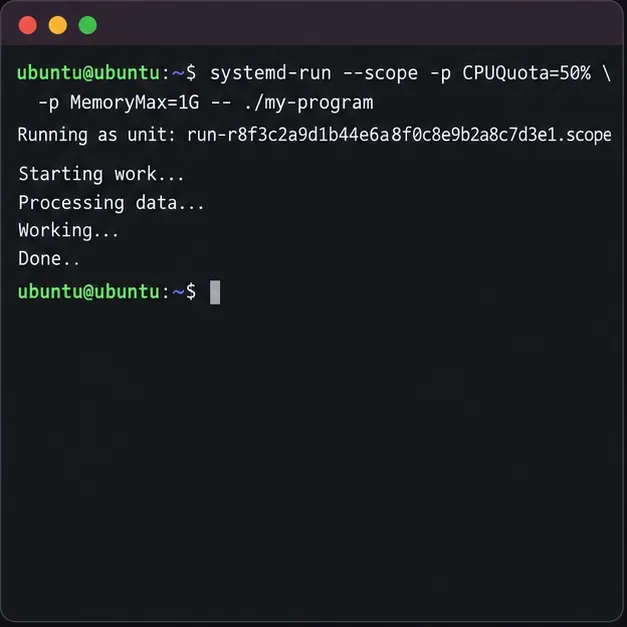
對於使用者擁有的命令,請先嘗試不執行該命令sudo。如果 systemd 報告請求的控制器或屬性不可用,則可能是使用者管理員沒有權限委派該控制器或屬性;對於系統級工作負載,以 root 使用者身分重試可能合適,但這會改變命令的安全上下文。切勿隨意以 root 使用者身分執行不受信任的程式。如果必須以 root 使用者身分使用系統管理器,請sudo systemd-run --scope ...務必在考慮此變更後再使用。
命令運作時,終端機會一直連接到示波器。按下按鈕Ctrl+C會中斷前台操作。示波器是臨時的,通常會在進程退出後消失。這是一種在限制條件下啟動命令的便捷方式,而不是為未來的啟動設定持久策略。
systemd-run列印它所建立的單元名稱,通常類似於run-….scope。命令仍在運行時,列出 cgroup 樹:
systemd-cgls找到瞬態作用域,並確認目標程式及其子程式都位於其下方。這一點很重要,因為在作用域之外運行的子程式將不受相同的 cgroup 上限的保護。
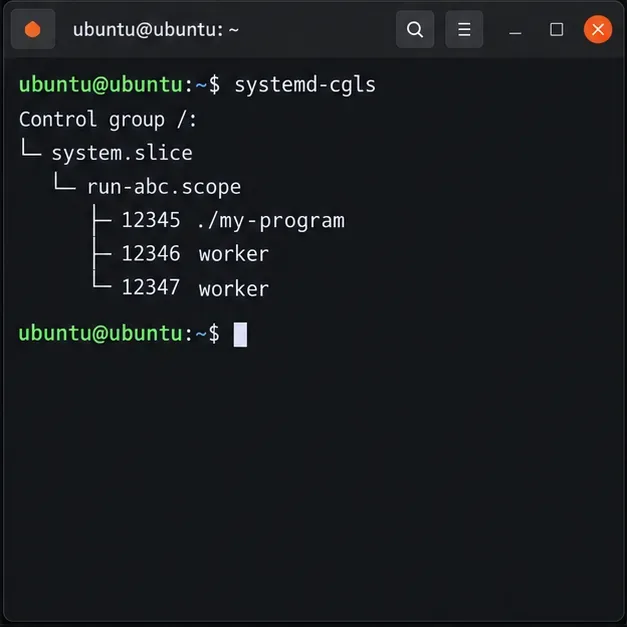
在下一個指令中使用列印出的作用域名稱。將 `<scope name>` 替換run-abc.scope為實際名稱:
systemctl show run-abc.scope \
-p ControlGroup -p CPUQuotaPerSecUSec -p MemoryMaxCPUQuotaPerSecUSec=50000當 systemd 的配額週期為 100 毫秒時,這與 50% 的配額一致;MemoryMax=1073741824大小為 1 GiB 位元組。即時值比假設每個主機都會原封不動地接受每個請求更有用,因為父 cgroup 和可用控制器可能會限制實際結果。
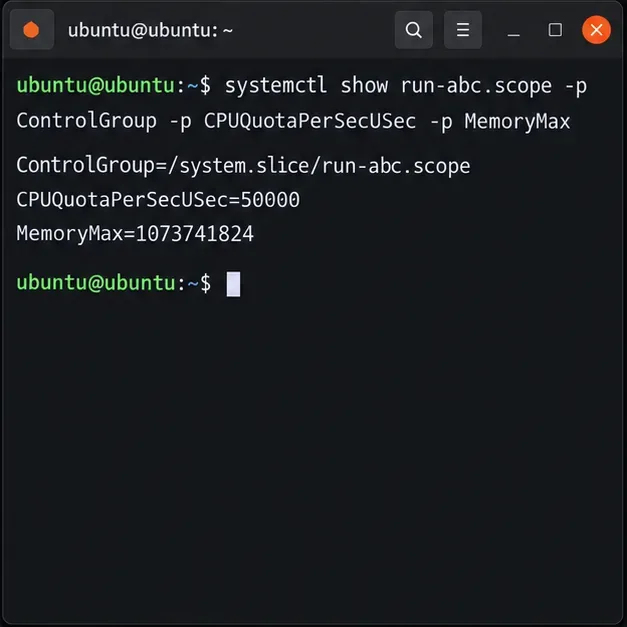
此ControlGroup屬性提供相對於目前位置的 cgroup 路徑/sys/fs/cgroup。將其儲存在 shell 變數中,以便命令遵循電腦上實際分配的路徑:
UNIT=run-abc.scope
CG=$(systemctl show "$UNIT" -p ControlGroup --value)
printf 'Group: %s\n' "$CG"
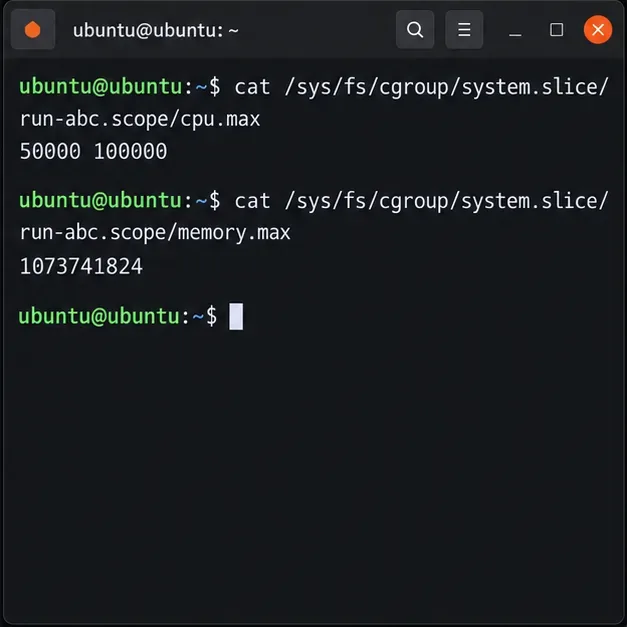
cat "/sys/fs/cgroup$CG/cpu.max"
cat "/sys/fs/cgroup$CG/memory.max"
cgroup v2 中cpu.max包含以微秒為單位的配額和週期。例如,50000 100000表示每 100 毫秒週期內分配 50 毫秒的 CPU 時間。memory.max顯示以位元組為單位的記憶體上限。如果檔案缺失,請確認作用域是否仍然有效,以及核心是否正在使用 cgroup v2。
如果您啟動了一個已命名的長時間運行單元,並且需要調整其限制,systemd 支援更改活動單元的資源屬性,例如 `systemd.configure("username")` sudo systemctl set-property --runtime my-worker.service CPUQuota=50% MemoryMax=1G。這適用於該服務的 cgroup,並且需要相應的權限。 systemd 不會因為知道進程 ID (PID) 就附加任意已運行的進程;對於一次性進程,請將其正常停止,然後透過受限範圍重新啟動。對於持久性服務,請在服務單元或 systemd drop-in 中配置屬性,並在適當的維護視窗期間重新啟動它。
檢查時請保持工作負載處於活動狀態。確認systemd-cgls進程及其子進程已置於預期的作用域內,已systemctl show報告請求的屬性,並且相應的cpu.maxcgroupmemory.max檔案存在且具有有限值。當進程退出時,瞬態作用域將被移除,因此其 cgroup 檔案可能會消失。
配額限制 CPU 時間,但不保證在桌面顯示器上顯示固定百分比,而硬性記憶體上限則可能導致應用程式運行失敗。如果工作負載變得不穩定,請停止該工作負載,並將限制提高到一個經過驗證的安全值,或使用更寬鬆的MemoryHigh=壓力閾值並配合更高的MemoryMax=記憶體使用率。有關具體行為,請查閱已安裝的 systemd 和核心文件;權威參考資料包括Ubuntu systemd-run 手冊、Ubuntu systemd resource-control 手冊和Linux 核心 cgroup v2 文件。
將按需作業運行替換為 systemd 定時器,該定時器每 15 分鐘執行一次 ownCloud 支援的 occ system:cron 命令。
透過 Apache、Nginx 或反向代理程式追蹤 WebDAV 請求,然後使用經過驗證的 PROPFIND 測試確認 ownCloud 同步功能正常。
透過設定其規範 URL 並從伺服器本身檢查 DNS、HTTPS 和反向代理路由,修復 Nextcloud 缺少出站位址警告的問題。
透過本機 Unix 套接字配置 APCu 和 Redis,以實現 Nextcloud 快取和檔案鎖定,並提供目前和舊版 Nextcloud 的步驟。
檢查 Nextcloud 的 cron 模式,修復其 systemd 服務和計時器,並驗證後台作業在啟動後以及每隔五分鐘運行一次。
啟用可靠的 Nextcloud 檔案鎖定,選擇適當的 Redis 或 Valkey 後端,並驗證警告是否清除,同時避免並發檔案變更的風險。
使用最新更新、HTTPS 和 HSTS、精確的反向代理信任以及針對公共伺服器的檢查,修復 Nextcloud 掃描中常見的錯誤。
為需要加密的儲存配置 Nextcloud SSE,保護加密金鑰,並在加密現有文件之前測量傳輸和 CPU 影響。
將 Nextcloud 的檔案搜尋連接到 Elasticsearch,索引文件內容,並選擇適合您的伺服器和安全需求的設定。
配置 Nextcloud 在規定的保留期後刪除已刪除的文件,可靠地安排後台作業,並避免執行清除所有使用者回收站的命令。


