使用 Systemd 定時器可靠地執行 ownCloud 後台作業
將按需作業運行替換為 systemd 定時器,該定時器每 15 分鐘執行一次 ownCloud 支援的 occ system:cron 命令。
如果 SUSE Linux Enterprise Server 在 systemd 關閉過程中掛起,請找出正在執行停止作業的單元,或檢查上次啟動的最後訊息,然後修復該單元或其相依性。單元是指 systemd 管理的資源,例如服務或掛載點;停止作業是 systemd 請求關閉某個單元的指令。不要先嘗試降低全域逾時時間或強制斷電,因為服務或檔案系統可能仍在關閉檔案或寫入資料。
本演練遵循 2026 年 10 月查閱的 SLES 15 SP7 文件。具體的停止策略取決於服務和儲存供應商,因此請根據他們的指導進行任何特定於設備的變更。
如果控制台顯示「正在執行停止作業,等待…」並附有倒數計時,請記下指定的服務或掛載點以及倒數計時是否有變更。這表示 systemd 正在等待該單元的停止操作,並不一定意味著作業系統崩潰;資料庫和遠端儲存可能需要一些時間才能正常關閉。
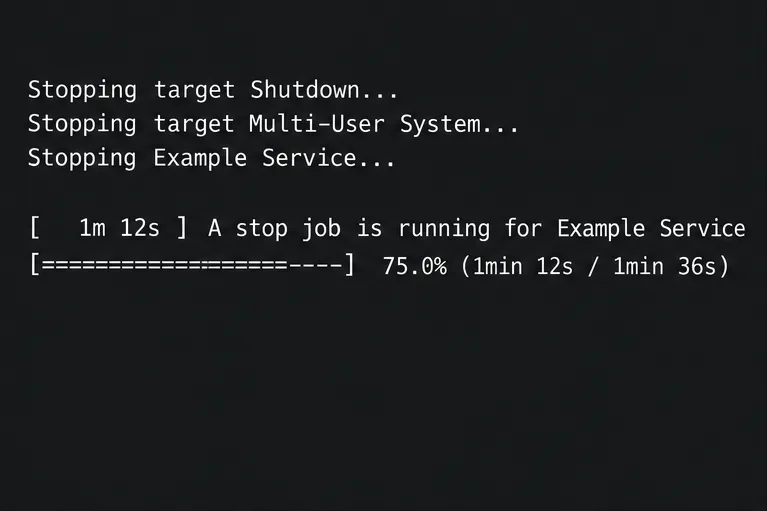
透過遠端控制台、串列埠控制台或其他可用終端進行觀察。寫入操作進行期間,請避免執行重設或電源指令。如果系統停止回應,請記錄最後可見的一行,並在系統啟動後繼續操作。
如果 SSH 或第二個終端仍然有效,請詢問 systemd 哪些作業正在運作或等待,然後檢查螢幕上顯示的單元名稱:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service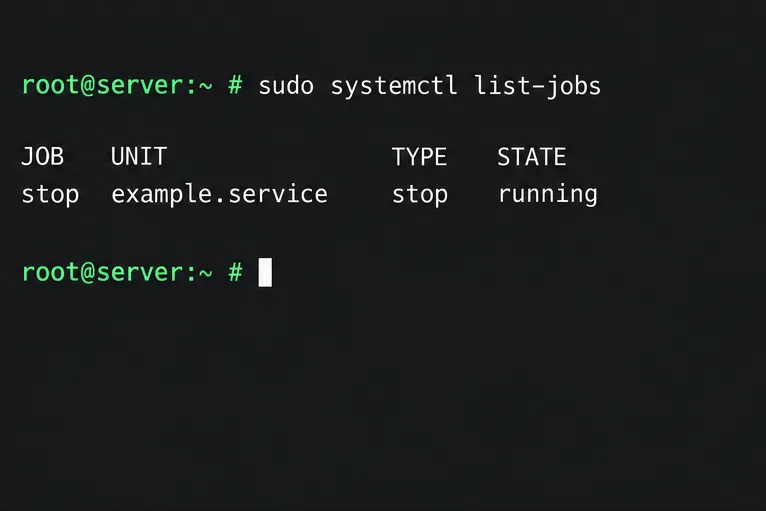
請替換SERVICE為實際的單元名稱。正在執行的停止作業可以縮小搜尋範圍,但無法解釋為何進程沒有退出。更改配置前,請先查看其狀態和日誌。如果 systemd 不再回應,請勿盲目取消作業;主機復原後,請檢查先前的日誌。
日誌是 systemd 的核心、服務和系統訊息的索引日誌。下次成功啟動後,列出已記錄的啟動程序並檢查上一次啟動的結尾:
sudo journalctl --list-boots
sudo journalctl -b -1 -e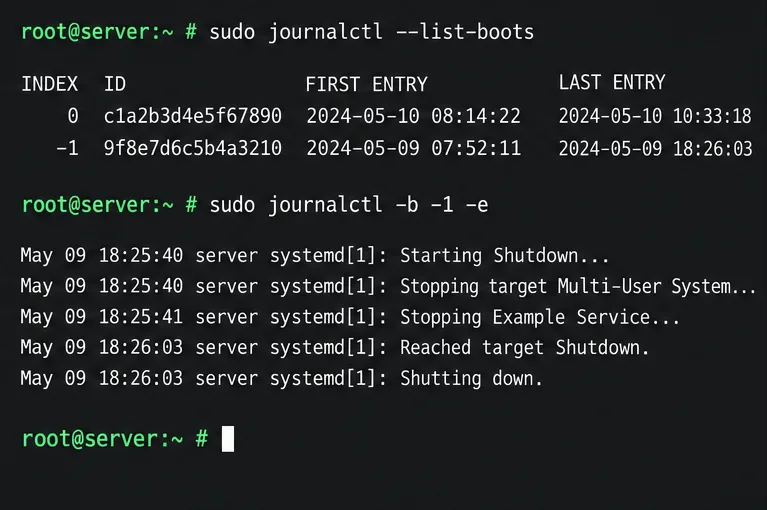
-1量選擇上一個啟動項,並-e移至其最近的條目。尋找最後一條「正在停止」訊息、逾時、重試記錄或指定的設備或掛載點。最後一行只是一個線索:關機順序可能會導致後面還有其他設備等待。比較時間戳記和附近的訊息。
當螢幕或日誌中出現服務名稱時,僅查詢該單元先前啟動的條目。同時檢查其已載入的配置:
sudo journalctl -b -1 -u SERVICE.service --no-pager
sudo systemctl cat SERVICE.service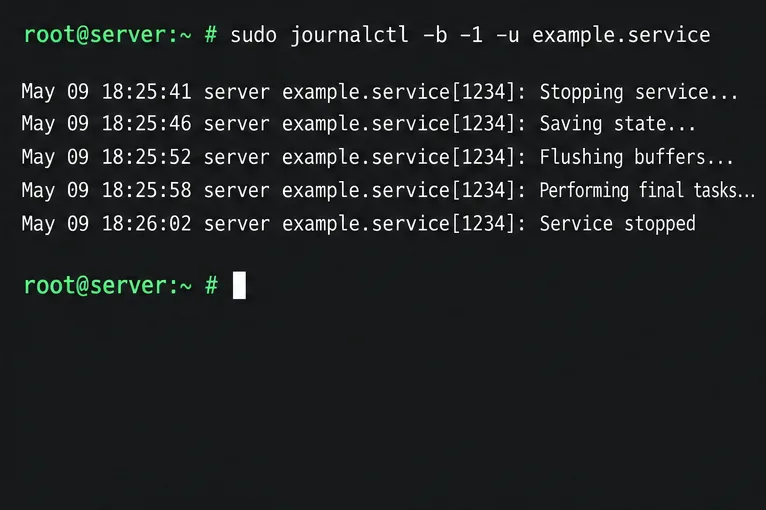
檢查是否存在自訂腳本ExecStop、無限期等待的腳本、未關閉的子進程或應用程式關閉鉤子中的錯誤。對於供應商提供的單元,請在編輯前將軟體包和配置與官方指南進行比較。
如果日誌中提到了掛載點、裝置或遠端檔案系統,請檢查掛載表以及以下位置的符合條目/etc/fstab:
sudo findmnt --verify --verbose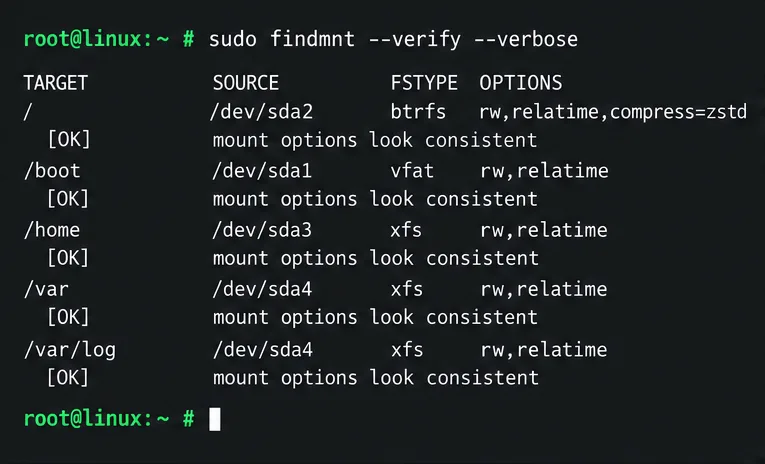
檢查 NFS、CIFS、iSCSI 或其他遠端相依性在關機期間是否可存取且符合預期。僅在確認不再使用後才刪除過時的掛載點。不要僅因重啟緩慢而強制卸載正在運行的檔案系統。
對於無法啟動的服務,請先修復其關閉腳本、應用程式設定或軟體包問題。每個單元的替換配置無需編輯供應商文件sudo systemctl edit SERVICE.service即可儲存。 SUSE 文件中提供了服務啟動或停止的說明;請為此工作負載使用供應商認可的值。/etc/systemd/system/TimeoutSec
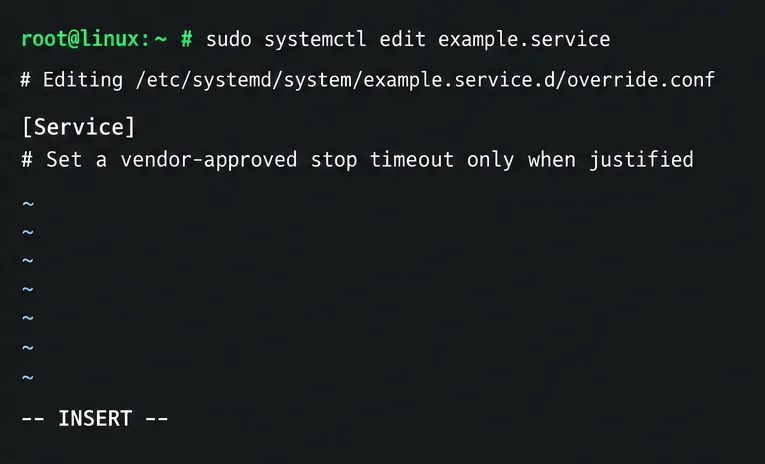
完成已記錄的編輯後,使用 `systemd -r` 指令重新載入 systemd 的單元定義sudo systemctl daemon-reload,並使用 `systemd -r` 指令檢查結果sudo systemctl cat SERVICE.service。較長的超時時間可以讓正常的關機完成,但也可能延長失敗的重新啟動時間。較短的超時時間可能會在服務刷新狀態之前將其終止。不要為了掩蓋某個單元的缺陷而更改全域預設值。
/run/log/journal/SLES預設將日誌資料儲存在某個位置,該暫存目錄會在重新啟動時清除。如果journalctl -b -1目錄沒有任何先前的啟動記錄,請啟用持久性日誌儲存以便將來進行診斷:
sudo mkdir -p /var/log/journal
sudo systemd-tmpfiles --create --prefix=/var/log/journal
sudo journalctl --flush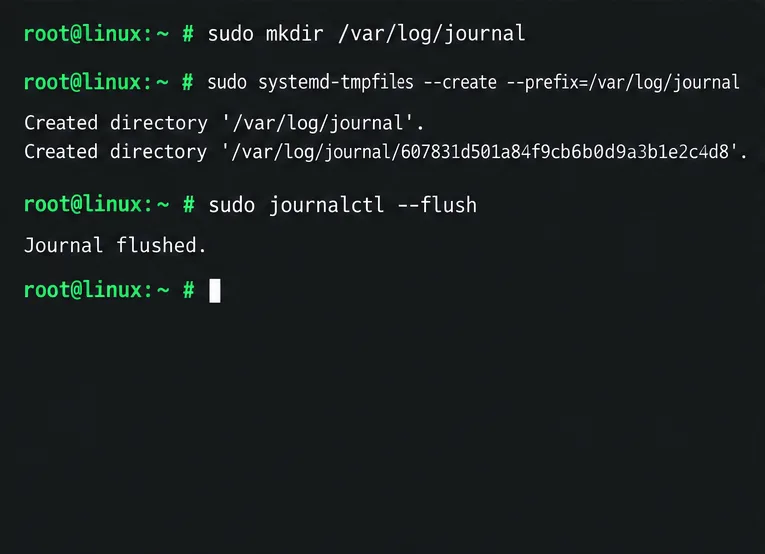
持久性日誌會佔用檔案系統空間/var;SUSE 指出,預設情況下,日誌可能會佔用該檔案系統高達 10% 的空間。請檢查可用空間和保留策略,尤其是在小/var卷上。
一旦疑似問題原因得到解決,安排一次可控重啟,並確保控制台存取權限可用。機器重新啟動後,檢查上次啟動的最後訊息,並確認服務的當前狀態:
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service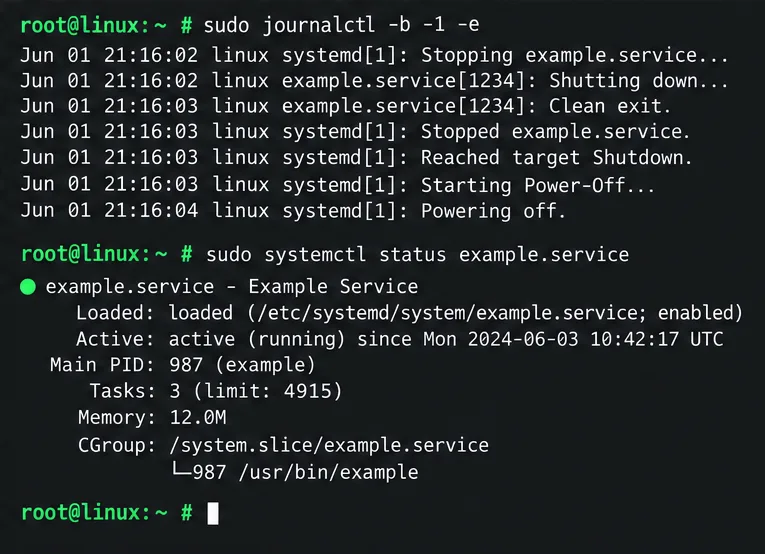
當伺服器在未等待相同單元的情況下關機、正常啟動且服務或掛載點正常運作時,問題即可解決。如果日誌突然結束或顯示核心、控制器或硬體錯誤,請保留日誌並與 SUSE 或硬體供應商聯繫進行調查,而不是調整逾時設定。
有關命令詳情,請參閱SLES 15 SP7 systemd 指南和 SUSE 的持久日誌和 journalctl 過濾器指南。這些步驟可以識別可能的阻塞因素;正確的服務、檔案系統或硬體修復方案取決於機器本身日誌中指定的單元。
將按需作業運行替換為 systemd 定時器,該定時器每 15 分鐘執行一次 ownCloud 支援的 occ system:cron 命令。
透過 Apache、Nginx 或反向代理程式追蹤 WebDAV 請求,然後使用經過驗證的 PROPFIND 測試確認 ownCloud 同步功能正常。
透過設定其規範 URL 並從伺服器本身檢查 DNS、HTTPS 和反向代理路由,修復 Nextcloud 缺少出站位址警告的問題。
透過本機 Unix 套接字配置 APCu 和 Redis,以實現 Nextcloud 快取和檔案鎖定,並提供目前和舊版 Nextcloud 的步驟。
檢查 Nextcloud 的 cron 模式,修復其 systemd 服務和計時器,並驗證後台作業在啟動後以及每隔五分鐘運行一次。
啟用可靠的 Nextcloud 檔案鎖定,選擇適當的 Redis 或 Valkey 後端,並驗證警告是否清除,同時避免並發檔案變更的風險。
使用最新更新、HTTPS 和 HSTS、精確的反向代理信任以及針對公共伺服器的檢查,修復 Nextcloud 掃描中常見的錯誤。
為需要加密的儲存配置 Nextcloud SSE,保護加密金鑰,並在加密現有文件之前測量傳輸和 CPU 影響。
將 Nextcloud 的檔案搜尋連接到 Elasticsearch,索引文件內容,並選擇適合您的伺服器和安全需求的設定。
配置 Nextcloud 在規定的保留期後刪除已刪除的文件,可靠地安排後台作業,並避免執行清除所有使用者回收站的命令。


