使用 Systemd 定時器可靠地執行 ownCloud 後台作業
將按需作業運行替換為 systemd 定時器,該定時器每 15 分鐘執行一次 ownCloud 支援的 occ system:cron 命令。
對於 SLES 15,請註冊 SUSE Linux Enterprise 高可用性擴展,然後使用crm cluster init該crm cluster join擴展引導節點。在叢集上部署服務之前,請先驗證冗餘網路、節點隔離 (STONITH) 和仲裁。
此流程遵循截至 2026 年 10 月的 SLE HA 15 SP7 文件。請確認您已安裝的服務包和 CPU 架構;註冊識別碼和支援詳細資訊可能有所不同。
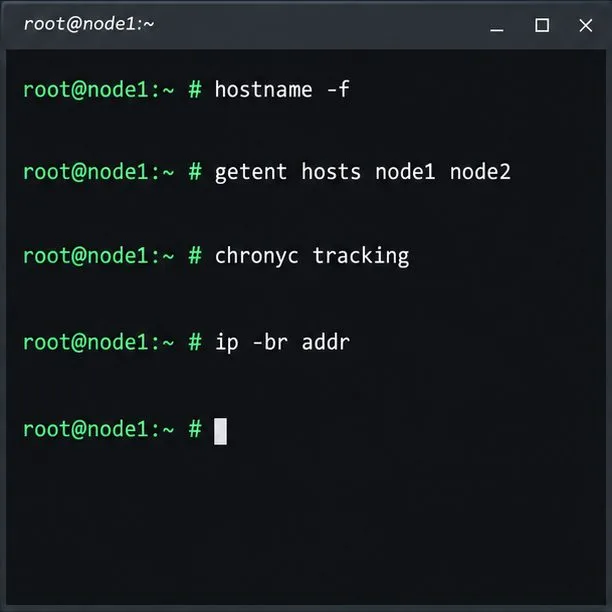
使用至少兩個採用相同支援處理器架構的節點,每個節點使用靜態主 IP 位址,每個節點使用可解析的唯一名稱,並使用外部時間來源同步時脈。 SUSE 要求每個節點兩條冗餘的 TCP/IP 通訊路徑;所有節點的介面名稱必須一致。
hostname -f
getent hosts node1 node2
chronyc tracking
ip -br addr
在啟動之前,請對兩個節點執行檢查,並確認所選介面和名稱是否正確。
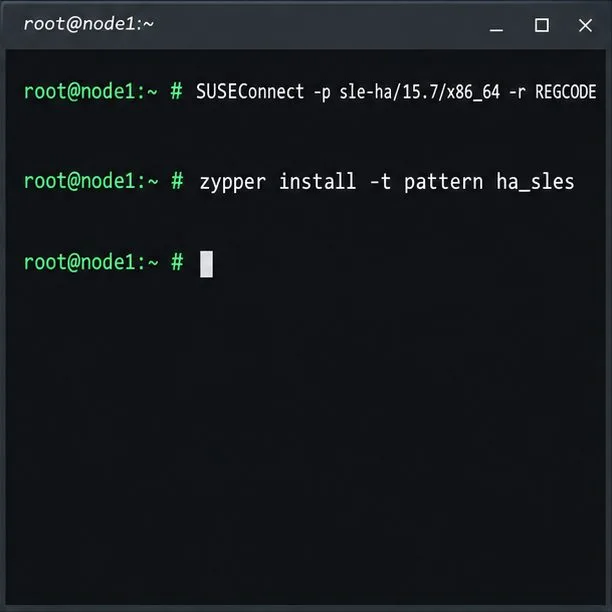
SLE HA 是一個單獨註冊的擴充;SLES 本身不包含叢集模式。對於已註冊的 SLES 15 SP7 x86_64 節點,請啟用該擴充功能並在每個節點上安裝該模式:
SUSEConnect -p sle-ha/15.7/x86_64 -r ADDITIONAL_REGCODE
zypper install -t pattern ha_sles請替換ADDITIONAL_REGCODE為您的訂閱代碼。產品識別碼適用於 x86_64 架構;其他架構請使用 SUSE 提供的符合識別碼。請確保所有節點運行在相同的 SLES SP 和 SLE HA 版本上。請參閱SUSE SLE HA 15 SP7 安裝指南。
支援的叢集需要啟用節點隔離(STONITH),並啟用 `with`stonith-enabled和startup-fencing`left` 參數。隔離功能可隔離不確定節點,防止分區兩側運行相同的服務。請為您的硬體或虛擬機器管理程式選擇支援的電源控制設備或具有經過測試的看門狗的 SBD。
對於雙節點叢集: SUSE 建議在偶數節點叢集中使用 QDevice/QNetd。它增加了一個獨立的仲裁投票機制,而不是隔離機制;如果在引導過程中包含 QDevice,請先設定單獨的 QNetd 伺服器。請參閱QDevice 和 QNetd 指南。
儲存迷思:共用儲存並非每個叢集的必需品,但應用程式資料需要其自身的共用、複製或可復原設計。 Pacemaker 負責遷移資源,而非複製應用程式資料。
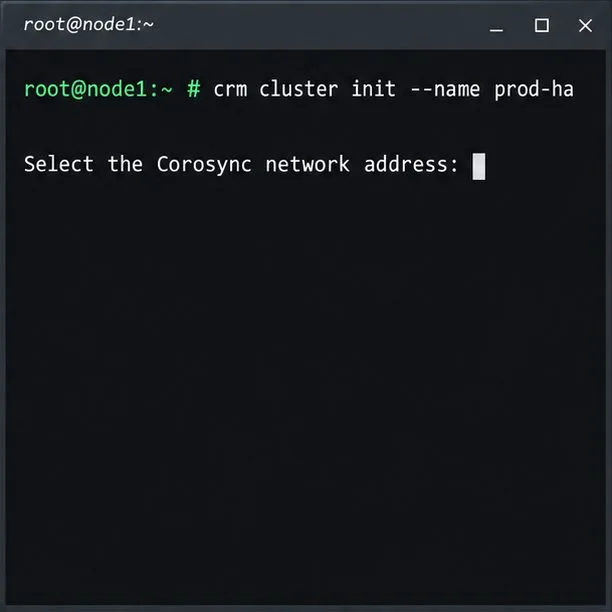
在節點 1 上,以 root 使用者身分或透過您已核准的 sudo 使用者設定啟動 CRM Shell 引導程式:
crm cluster init --name prod-ha依照指示選擇所需的 Corosync 位址。此腳本會配置 Corosync、SSH、Csync2、叢集防火牆連接埠和 Hawk2;它會檢查時間同步,並提供可選的 SBD 和 Hawk2 管理 IP 位址。請查看/var/log/crmsh/crmsh.log引導設定。
在選擇 SBD 之前,請在每個節點上設定看門狗。如果使用外部隔離,請在工作負載啟動之前設定其支援的 STONITH 資源。切勿為了繞過缺少的設備而停用 STONITH。引導程式創建的是基本集群,而非高可用性 (HA) 應用。
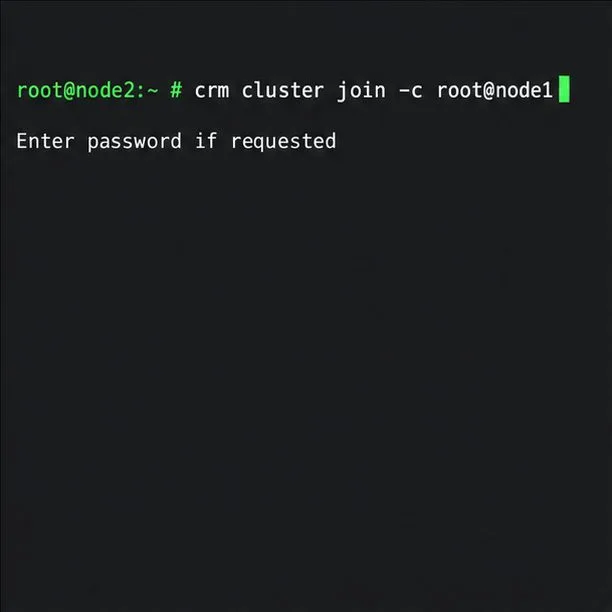
在節點 2 上安裝並註冊 SLE HA。如果使用 SBD,請在加入 HA 之前配置好其看門狗。然後,以 root 使用者身分執行以下操作:
crm cluster join -c root@node1對於 sudo 使用者配置,請使用 SUSE 的USER@NODE1步驟。如果初始化時已配置,請指定相同的兩個介面。腳本會複製 Corosync 設置,設置 SSH 和 Csync2,並使節點 2 上線。對更多節點重複此動作;請勿混用引導程式和 YaST 設定方法。
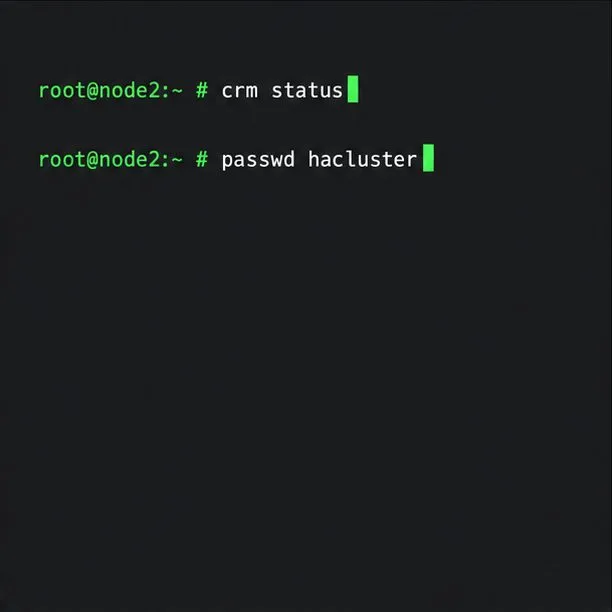
從叢集節點檢查成員資格:
crm status確認兩個節點均在線且達到法定人數。引導程式會hacluster使用初始密碼建立實例linux;請在每個已初始化的節點上變更密碼:
passwd haclusterHawk2 使用 HTTPS 協議,連接埠為7630。在信任自簽名憑證之前,請務必先與您的管理員確認其有效性。 Hawk2 管理 IP 位址並非應用程式的用戶端位址。
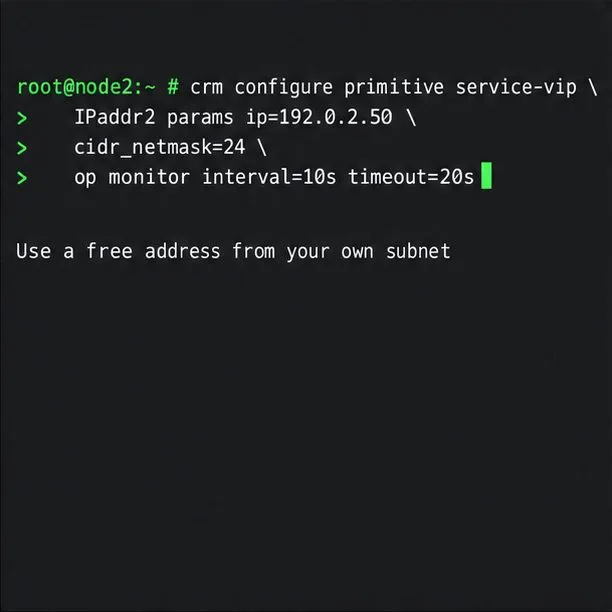
Pacemaker 透過資源代理人管理服務。在符合條件的節點上正確安裝和配置工作負載。此範例僅建立一個浮動 IP 原語:
crm configure primitive service-vip IPaddr2 params ip=192.0.2.50 cidr_netmask=24 op monitor interval=10s timeout=20s192.0.2.50此位址保留用於文件記錄。請替換為子網路中的可用位址和正確的前綴。 IP 原語不會啟動應用程式或複製資料。請新增應用程式支援的代理,以及特定於工作負載的排序、託管和儲存行為;並遵循該產品的復原和隔離指南。
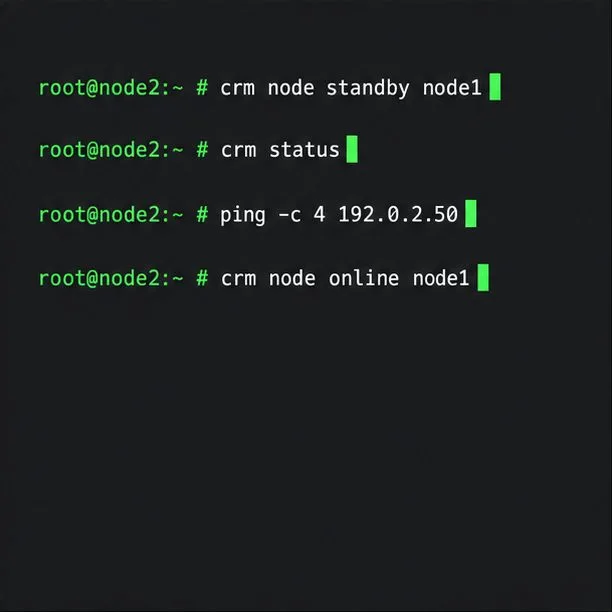
配置實際資源和隔離機制後,安排一次受控故障轉移測試。將節點 1 置於備用狀態,並從節點 2 檢查服務:
crm node standby node1
crm status
ping -c 4 SERVICE_VIP
crm node online node1替換SERVICE_VIP為真實的客戶端位址。確認應用程式回應正常,資源按預期遷移,並且 node1 重新加入網路。 Ping 僅檢查網路可達性。 SUSE 會crm cluster crash_test故意中斷元件,因此請在已規劃的測試環境中使用。請閱讀SLE HA 安裝快速入門和隔離指南。
測試後,確認兩個節點均處於預期狀態,隔離功能保持啟用狀態,且節點 1 恢復在線後,工作負載能夠透過其客戶端端點回應。僅憑成員視圖顯示綠色或 ping 通並不能證明應用程式已恢復。
將按需作業運行替換為 systemd 定時器,該定時器每 15 分鐘執行一次 ownCloud 支援的 occ system:cron 命令。
透過 Apache、Nginx 或反向代理程式追蹤 WebDAV 請求,然後使用經過驗證的 PROPFIND 測試確認 ownCloud 同步功能正常。
透過設定其規範 URL 並從伺服器本身檢查 DNS、HTTPS 和反向代理路由,修復 Nextcloud 缺少出站位址警告的問題。
透過本機 Unix 套接字配置 APCu 和 Redis,以實現 Nextcloud 快取和檔案鎖定,並提供目前和舊版 Nextcloud 的步驟。
檢查 Nextcloud 的 cron 模式,修復其 systemd 服務和計時器,並驗證後台作業在啟動後以及每隔五分鐘運行一次。
啟用可靠的 Nextcloud 檔案鎖定,選擇適當的 Redis 或 Valkey 後端,並驗證警告是否清除,同時避免並發檔案變更的風險。
使用最新更新、HTTPS 和 HSTS、精確的反向代理信任以及針對公共伺服器的檢查,修復 Nextcloud 掃描中常見的錯誤。
為需要加密的儲存配置 Nextcloud SSE,保護加密金鑰,並在加密現有文件之前測量傳輸和 CPU 影響。
將 Nextcloud 的檔案搜尋連接到 Elasticsearch,索引文件內容,並選擇適合您的伺服器和安全需求的設定。
配置 Nextcloud 在規定的保留期後刪除已刪除的文件,可靠地安排後台作業,並避免執行清除所有使用者回收站的命令。


