2026 年科技賦能的老年照護:人工智慧和智慧家庭能為居家養老做些什麼,以及它們有哪些限制

2026 年實用指南,涵蓋人工智慧、智慧家居感應器、遠端監控、防跌倒安全、隱私以及如何利用科技在不取代護理的情況下支援居家養老。
新一代人工智慧和超級運算硬體並非由單一突破驅動,而是由多種技術協同建構而成:包括全環柵電晶體、背面供電、晶片級架構、先進封裝、高頻寬記憶體、更快的晶片間鏈路,以及日益普及的光網路。其最終成果是更強大的運算能力、更高的記憶體頻寬和更優異的可擴展性,而無需僅依賴較小的電晶體尺寸。
這一點至關重要,因為現代人工智慧加速器和科學超級電腦往往在耗盡原始算術能力之前,就已經面臨資料傳輸和功耗的限制。只有當模型權重、激活值和中間結果能夠足夠快地傳輸到矩陣引擎時,更快的矩陣引擎才能發揮作用。同樣,只有當封裝、機架網路、記憶體系統、冷卻系統和軟體棧能夠保證加速器高效運作時,增加加速器的數量才能真正發揮作用。
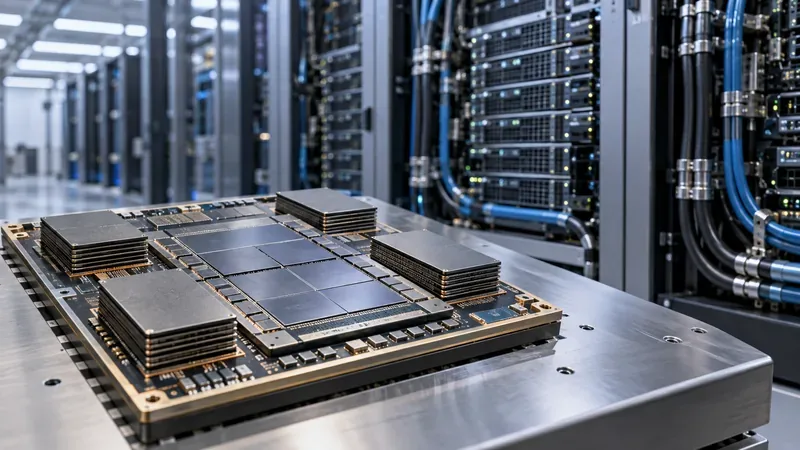
前沿邏輯電路正在超越多年來主導先進晶片的FinFET結構。全環柵極(GAA)設計將閘極包裹在奈米片或類似通道結構周圍,使晶片設計人員能夠在尺寸縮小時更精確地控制靜電。這可以提高效能、降低漏電,或在兩者之間取得更好的平衡。
台積電表示,其2奈米N2製程將於2025年第四季實現量產,而其A16技術則將奈米片電晶體與背面供電軌結合,主要面向對高密度供電需求的高性能運算產品。台積電曾表示,A16技術計劃於2026年下半年實現量產。請參閱台積電的A16技術頁面及2025年年度報告。
英特爾的 18A 製程也遵循類似的發展方向。此製程結合了 RibbonFET GAA 電晶體和 PowerVia 背面供電技術。英特爾表示,18A 將於 2025 年投產,而增強型 18A-P 版本將於 2026 年 6 月進入風險生產階段。英特爾也公佈了該製程節點的效能、功耗和密度比較數據;這些數據由廠商提供,應根據具體設計進行驗證,而非視為通用的晶片級性能提升。更多詳情請瀏覽英特爾18A 工藝頁面。
背面供電至關重要,因為先進晶片必須透過極其密集的佈線來傳輸訊號和電力。將部分供電網路移至背面可釋放訊號側的佈線資源,並改善電壓傳輸。對於人工智慧加速器而言,由於其運算單元陣列以極高的頻率進行切換,背面供電的重要性不亞於電晶體密度。
隨著晶片尺寸的增加,單晶片的擴展難度和成本都會增加。晶片組則提供了另一種解決方案:可以將各個功能分別採用最適合的製程技術進行製造,然後封裝在一個晶片內。例如,計算晶片可能需要最先進的邏輯工藝,而I/O、快取、類比電路或其他功能則可能不需要。
封裝是實現這一目標的關鍵。例如,台積電的CoWoS先進封裝平台旨在將多個邏輯元件和高頻寬記憶體堆疊整合到2.5D封裝中。台積電將CoWoS定位為人工智慧和高效能運算產品,在這些產品中,運算單元和高頻寬記憶體單元之間的短而寬的連接至關重要。
為了降低晶片的專有性,相關標準也不斷湧現。 UCIe 3.0 規範於 2025 年 8 月發布,支援 48 GT/s 和 64 GT/s 的資料速率,並新增了提高電源效率、可管理性和建構更靈活的多晶片系統等功能。 UCIe 並不能在一夜之間實現晶片的互換性,但它為業界提供了一個通用的封裝內鏈路電氣和協定框架。
當公司希望利用可重複使用的建造模組來建立多個加速器變體時,這種方法尤其具有吸引力。但如果封裝成本、熱密度或設計複雜性超過了模組化帶來的優勢,那麼這種方法的吸引力就會降低。對於記憶體和 I/O 需求不高的較小產品而言,更簡單的單晶片裝置可能仍然是更好的選擇。
人工智慧工作負載需要重複在記憶體和運算單元之間傳輸大型張量。這使得記憶體頻寬成為首要的設計限制。高頻寬記憶體(HBM)透過堆疊DRAM晶片,並利用非常寬的介面將它們物理放置在靠近加速器的位置,從而解決了這個問題。
HBM4 現已從路線圖階段邁向商業化階段。三星宣布將於 2026 年 2 月開始商業化 HBM4 的出貨,並表示其產品已進入量產階段,持續傳輸速率為 11.7 Gb/s,最高可達 13 Gb/s。 2026 年 5 月,三星也宣布開始出貨 HBM4E 樣品。這些詳細資訊可在三星的HBM4 生產公告中找到。
SK海力士在2026年第二季業績報告中表示,已於本季開始批量出貨HBM4,並計劃在下半年提高產能。該公司也交付了12層HBM4E樣品。有關最新進展,請參閱SK海力士2026年第二季業績報告。
這在實際應用中為何如此重要? NVIDIA 目前的 Vera Rubin 規格說明中,單一 Rubin GPU 配備 288 GB HBM4 記憶體,GPU 顯存頻寬為 19.2 TB/s。相較之下,AMD 的 MI350 系列加速器採用 HBM3E 記憶體;AMD 為 MI355X 標稱的顯存容量最高可達 288 GB,顯存頻寬最高可達 8 TB/s。這兩種架構不同,不應僅憑頻寬資料進行比較,但它們都表明,顯存容量和頻寬如今已成為加速器的核心規格,而非次要細節。請參閱NVIDIA Vera Rubin NVL72 官方規格說明和AMD Instinct MI350 系列頁面。
大型模型和科學模擬很少能完全在一台設備上運作。系統必須將工作分配給多個加速器,並頻繁地交換部分結果。如果通訊速度慢,昂貴的計算單元就會閒置。
這就是為什麼專有的可擴展互連架構與GPU本身同步發展的原因。 NVIDIA的Rubin平台採用第六代NVLink;NVIDIA官方資料顯示,每個Rubin GPU的NVLink頻寬為3 TB/s,而整個NVL72系統的總頻寬為216 TB/s。 AMD在其加速器平台上使用Infinity Fabric。對於買家而言,重要的不僅是鏈路峰值頻寬,還有互連架構在應用程式使用的具體操作、模型並行模式和拓撲結構下的表現。
在系統記憶體層面,Compute Express Link ( CXL) 也在不斷發展。 CXL 聯盟表示,CXL 4.0 將訊號傳輸速度從 64 GT/s 提升至 128 GT/s,增加了捆綁端口,並擴展了記憶體可靠性功能。當架構師希望實現一致的記憶體擴展、池化或解耦,而無需將每個記憶體層視為遠端儲存裝置時,CXL 就顯得尤為重要。
銅纜在短距離、高密度電氣連接方面仍然表現出色,但隨著距離和總頻寬的增加,光鏈路的吸引力日益增強。下一步的重要發展方向是光元件共封裝,即將光元件放置在更靠近網路專用積體電路 (ASIC) 的位置,而不是像現在這樣完全位於交換器邊緣的可插拔收發器中。
NVIDIA 表示,其 Spectrum-X 乙太網路光子平台採用共封裝光元件,網路能源效率比傳統可插拔收發器設計提升高達 5 倍。這只是廠商間的對比,並非對所有資料中心拓撲結構的保證,但它凸顯了發展方向:網路功耗的重要性日益凸顯,光整合如今已成為半導體系統設計的一部分。請參閱 NVIDIA 的矽光子學概述。
| 工作量 | 半導體特性優先考慮 | 它們為何重要 |
|---|---|---|
| 大型模型預訓練 | HBM容量和頻寬、快速擴展鏈路、高密度封裝、強大的冷卻能力 | 訓練過程中,張量移動和多個加速器之間的同步通訊需要耗費大量資源。 |
| 長語境和能動性推斷 | 大型 HBM 池、高效率的低精度計算、高互連頻寬、記憶體分層 | KV 快取和重複推理步驟可能會使記憶體容量和資料傳輸比峰值 FLOPS 更受限制。 |
| 科學高效能運算 | FP64 功能、記憶體頻寬、可靠的互連、成熟的數值庫 | 模擬程式碼通常依賴雙精度和持續頻寬,而不僅僅是低精度張量吞吐量。 |
| 企業推斷 | 每瓦效能、軟體相容性、適當的記憶體容量、PCIe部署選項 | 最佳系統可能是適合現有伺服器和電源容量的系統,而不是密度最高的機架架構。 |
| 自訂加速器 | Chiplet策略、封裝生態系、UCIe支援、製程成熟度 | 模組化可以縮短重複使用週期,但包裝的複雜性和供應鏈的資格認證可能會抵消這種優勢。 |
假設一個團隊正在維護一個大型語言模型,該模型具有較長的上下文視窗。效能分析顯示,GPU 經常處於等待記憶體傳輸和跨 GPU 通訊的狀態。升級到更新的加速器或許有所幫助,但前提是新系統必須提供足夠的 HBM 容量、更快的記憶體頻寬以及能夠減少通訊中斷的網路拓撲結構。如果購買的設備在記憶體和網路瓶頸不變的情況下,理論上的張量效能更高,那麼實際帶來的提升可能遠低於其標稱的效能指標。
同樣的原理也出現在傳統超級運算中。橡樹嶺國家實驗室的 Frontier 系統將 AMD MI250X 加速器與 HBM 記憶體和高速系統互連結合。 Frontier使用者指南詳細介紹了運算、HBM 記憶體、CPU-GPU 連結以及 Slingshot 網路如何協同運作。雖然該硬體的時代比 2026 年最新的 AI 平台要早,但其架構理念仍然適用:應用程式的持續效能取決於運算、記憶體和其他節點之間的路徑。
升級最合理的理由是它能解決實際的效能瓶頸,而不是簡單地更換舊零件。在決定升級到新一代加速器之前,請先檢查以下幾點:
半導體技術的進步帶來了令人矚目的性能,但其限制也日益凸顯。先進的封裝尺寸更大,製造難度更高。 HBM堆疊會使高功率邏輯電路附近產生熱集中。機架級系統可能需要液冷、高密度配電和專用網路。共封裝光元件可以降低網路功耗,但也帶來了新的製造和維護方面的挑戰。晶片組可以提高模組化程度,但會增加驗證、封裝和良率管理方面的工作。
軟體方面也存在權衡。低精度運算(例如 FP8、FP6 或 FP4)可以顯著提高 AI 的吞吐量,但軟體必須確保模型的品質。科學計算程式碼可能無法使用相同的捷徑。半導體特性只有在應用堆疊能夠利用它而不違反精度或可靠性要求時才有價值。
展望2026年剩餘時間和2027年,最重要的訊號不僅僅是新的製程節點名稱。也要關注台積電的A16和英特爾的18A系列製程能否廣泛應用於客戶產品;HBM4和HBM4E的規模化供應速度如何;UCIe 3.0能否實現真正意義上的多廠商晶片互通性;CXL 4.0在生產系統中的應用;以及共封裝光器件在大規模部署中是否高效且易於維護。
這些里程碑將表明,半導體產業能否在不讓記憶體移動、電源輸送、網路和冷卻消耗掉更密集邏輯所帶來的收益的情況下,繼續擴展人工智慧和超級運算。
人工智慧和超級運算的未來不再僅僅依賴單一的“下一代節點”,而是更多地依賴協調一致的半導體工程。 GAA電晶體和背面供電技術改進了邏輯基礎。晶片組和先進封裝技術使設計人員能夠組裝比單一晶片所能輕鬆提供的更大的系統。 HBM4以極高的頻寬為加速器供電。 UCIe、CXL、NVLink、Infinity Fabric和光網路技術則實現了在越來越大的網域內傳輸資料。
如果您正在選擇硬件,請先考慮工作負載的實際瓶頸。對於記憶體密集型人工智慧,優先考慮 HBM 容量和頻寬。對於分散式訓練,優先考慮縱向擴展和橫向擴展架構。對於科學計算,驗證 FP64 和函式庫的效能。對於企業部署,決策時應考慮功耗、散熱、軟體支援和整合工作量。理論上最快的半導體不一定就是最適合您工作負載的最快或最經濟的系統。
2026 年實用指南,涵蓋人工智慧、智慧家居感應器、遠端監控、防跌倒安全、隱私以及如何利用科技在不取代護理的情況下支援居家養老。
了解城市如何將交通、土地利用、氣候和社區數據轉化為更安全、更綠色、更適合步行的社區,同時又不將科技置於人之上。
比較領先的無人機和航空航天工程課程,包括無人機、自主性、控制、無人機系統操作和研究生研究,並附有經核實的 2026 年更新資訊。
人工智慧驅動的手術機器人實用指南:當前功能、自主程度、精確優勢、限制、監管和評估標準。
碳捕獲、利用與封存(CCUS)投資正在成長,但碳捕獲技術真的能扭轉全球碳排放嗎?看看它在哪些方面行之有效,規模受限於哪些因素,以及哪些證據至關重要。
比較七個全球數位供應鏈、物流、分析、全球貿易和營運項目,並提供選擇合適項目的實用指導。
了解腦機介面如何解碼神經訊號以恢復溝通和運動,近期研究取得了哪些成果,以及目前還有哪些因素限制了腦機介面的使用。
了解商用無人機如何將感測器、邊緣人工智慧、電池、通訊和飛行控制軟體結合起來——以及自主性在哪些方面仍然取決於任務和法規。
Compare seven strong battery and energy storage master's options by materials, systems, research, industry exposure, flexibility, language, and cost trade-offs.
了解有效載荷品質、電池限制、天氣、推進效率和飛機架構如何影響工業無人機的續航能力,以及如何提高續航力。








